GPT-6 Astra:新一代智能
- 发布 GPT-6 Astra,智能程度和对齐程度均达新高
- Astra 在多领域达到 state-of-the-art 水平,包括数学、软件工程、网络安全
- Astra 具备高效的专业工作能力,提升计算机操作速度和准确性
- Astra 在编程领域表现卓越,代码质量更高
- Astra 推进科学发现,刷新数学和科学评测记录
官方首屏演示视频(2 分 43 秒):从「画一个小黄圆圈」开始,逐步升级成火箭舷窗、Blender 3D 模型、雨衣演示文稿、eBay 二手 listing、躲避小行星的 3D 游戏、订餐、律所许可协议、订网球场,最后生成可 3D 打印的 STL 文件。播放器右下角 CC 按钮可切换字幕。
新一代智能
我们发布 GPT-6 Astra,这是目前世界上智能程度最高、对齐程度也最高的模型。
GPT-6 Astra 汇集了 OpenAI 多年来在预训练、强化学习和对齐方向上的研究积累与大胆押注。在计算机操作、浏览、软件工程、网络安全、科学研究和专业工作上,Astra 都达到了当前最佳(state-of-the-art)水平。它在 FrontierMath Tier 4 上拿下 98% 的分数,接近饱和,此前它已经协助解决了数学领域的多个长期公开难题;在 ARC-AGI-3 上拿下 99.9%,在 ExploitBench 上拿下 100%。它同时把计算机和浏览器的使用能力推到了新的高度,以前所未有的速度、准确性和判断力处理最苛刻的专业工作。
GPT-6 Astra 今天开始向有限的组织推出,未来几天将面向所有 ChatGPT Plus、Pro、Business 和 Enterprise 用户开放,同时通过 OpenAI API 和 AWS 提供。
Terminal-Bench Science 0.1 测试智能体能否用代码和终端工具完成科研工作流,包括分析数据、运行仿真和拟合模型。GPT-6 Astra 在对比模型中创下新高达 64.6%,Claude Fable 5.1 为 52.6%,而预估 API 成本还要低约 31%。在更低成本的设置下,Astra 得分 61.1%,GPT-5.6 Sol 的最好成绩是 22.4%,预估 API 成本同样低约 27%。
Astra 是我们对齐程度最高的模型,在理解用户意图和模型自身行为方面都有实质性改进,你可以更放心地把任务委托给它。作为检验方式之一,我们参考 Hugging Face 事件构建了一个新评测,考察模型面对困难甚至不可能完成的任务时,是否会越出预期范围。在没有生产环境防护的情况下,GPT-5.6 Sol 有 48% 的情况越出了授权目标,而 GPT-6 Astra 为 0%。
全球最强的计算机操作模型
GPT-6 Astra 在计算机操作的速度、准确性和安全性上树立了新标杆。它可以处理填在线表单、在 CRM 里更新客户记录、整理日历这类繁琐事务;可以上网做调研,在你的邮箱或文档编辑器里起草摘要;可以分析科学数据、绘制图表、创建网站,并跑一遍前端 QA 检查,确认网站上的功能都正常;还可以自主安装和测试软件,排查你在屏幕上看到的问题。这些改进也体现在我们当前最佳的评测结果里。
Agents' Last Exam 在真实软件中测试智能体完成复杂专业任务的能力,覆盖金融建模、工程和媒体制作。GPT-6 Astra 在对比中创下新高达 59.3%,Claude Opus 5 为 55.5%,GPT-5.6 Sol 为 53.6%。在取得最高分的设置下,Astra 使用的输出 token 还比 Opus 5 少约 65%。
这些改进也带来了真实知识工作中的显著效率提升。在 OSWorld 2.0 的延迟模拟中,Astra 每个任务用时减少约 47%,同时计算机操作成绩更高:约 40 分钟完成一个任务拿到 72.6%,而 GPT-5.6 Sol 约 75 分钟拿到 65.7%。
GPT-6 Astra 的计算机操作能力可以在各领域的产出中看到,包括游戏开发、电气工程和日常工作:
演示视频(15 秒浓缩回放):GPT-6 Astra 在 KiCad 中完成印制电路板(PCB)布局,通过摆放元件、布设铜连线,把电路原理图变成可制造的 PCB。PCB 布局是当今每种电子设备的核心环节,长期依赖手工完成,也是电子设计流程中常见的延期源头。把它加速,意味着工程师能以更高的节奏去发明、优化和验证下一个想法。
伴随 Astra,我们还更新了 Codex 的执行框架(harness),大幅提升计算机操作速度。结合 Astra 本身的效率,在 Mind2Web 基准上,任务完成速度比当前 GPT-5.6 Sol 体验快 1.9 倍。速度上的提升意味着它可以替你完成许多耗时的生活事务,而且比你动手更快。
“我们在发布当天就把 GPT-6 Astra 集成进了 Devin 的执行框架,它在我们的内部测试基准上达到了业界最佳水平。出色的计算机操作、写作和代码库理解能力开箱即用地改进了测试环节:视频明显更容易跟进,报告也更清晰简洁。”
专业工作的一次阶跃式提升
GPT-6 Astra 把计算机操作的进展与面向专业环境的定向训练结合起来,帮助处理复杂的工作任务。它既具备解决复杂问题所需的智能,又能执行多步骤工作流,产出打磨过的文档、表格和演示文稿。
BenchCAD 测试模型能否通过生成 CAD 代码,从多视角渲染图重建 3D 物体。借助工具,GPT-6 Astra 在对比中创下新高达 95.9% 的几何重合度分数,GPT-5.6 Sol 为 83.3%,Claude Fable 5.1 官方报告为 84.3%。在展示的配置下,预估 API 成本比 Sol 低约 43%,比 Fable 5.1 低约 86%。
GPT-6 Astra 是我们最擅长遵循现有模板的模型,产出的幻灯片版式规整,能沿着有结构的主线简明传达要点。它创建的文档、演示、表格和分析清晰且结构良好,遵循你的模板并贴合你的写作与视觉风格。Astra 还经过专门训练,只把真正相关的上下文带进产出,而不是重复与手头工作无关的信息。这一切意味着它产出的交付物更接近可直接使用,且符合你的业务背景和标准。
演示:GPT-6 Astra 仅用 OpenAI 演示模板中的几页幻灯片,就为虚构模型 GPT-Gaia 创建了一套演示文稿,全程保持了正确的语气和版式(参考文件对比 GPT-6 Astra 输出)。这意味着你可以期待幻灯片的格式正确符合你的业务标准。
GPT-6 Astra 还为它构建的网站、游戏、应用和渲染成果带来了更强的视觉判断力。借助 ChatGPT 中的 Sites 功能,Astra 可以直接从一句提示词创建、托管和分享网站、Web 应用和游戏。
“Astra 在能力和效率上都给了我们显著优势。它成功执行了我们最复杂的创意工作流,同时比我们测试过的其他模型少用最多 20% 的 token。最重要的是,对我们的客户来说,这意味着更高的产出质量。”
演示视频:GPT-6 Astra 在 Blender 中为房屋建模,并转成 Unreal Engine 5 中可行走的场景,帮助设计师和客户在开工之前探索布局、体验空间。
该模型可以通过生动的画面、有吸引力的玩法和精准的动作让游戏活起来,让非技术用户在几分钟内创建并游玩超越基础元素的定制游戏。视频来源:Pietro Schirano。
当指令留有解读空间时,GPT-6 Astra 比以往的模型更善于做出正确判断。它会利用上下文补齐常规空缺,在答案可能改变结果时提出聚焦的问题。在 Codex 中,它可以异步提问,同时继续处理不依赖你回复的工作。如果你没有回应,在合适的情况下它会基于合理假设继续推进,但在重大决策上会等待你的输入。
下面的例子展示了 Astra 如何在日常任务中协作,这些任务里缺失的信息可能实质性改变答案。
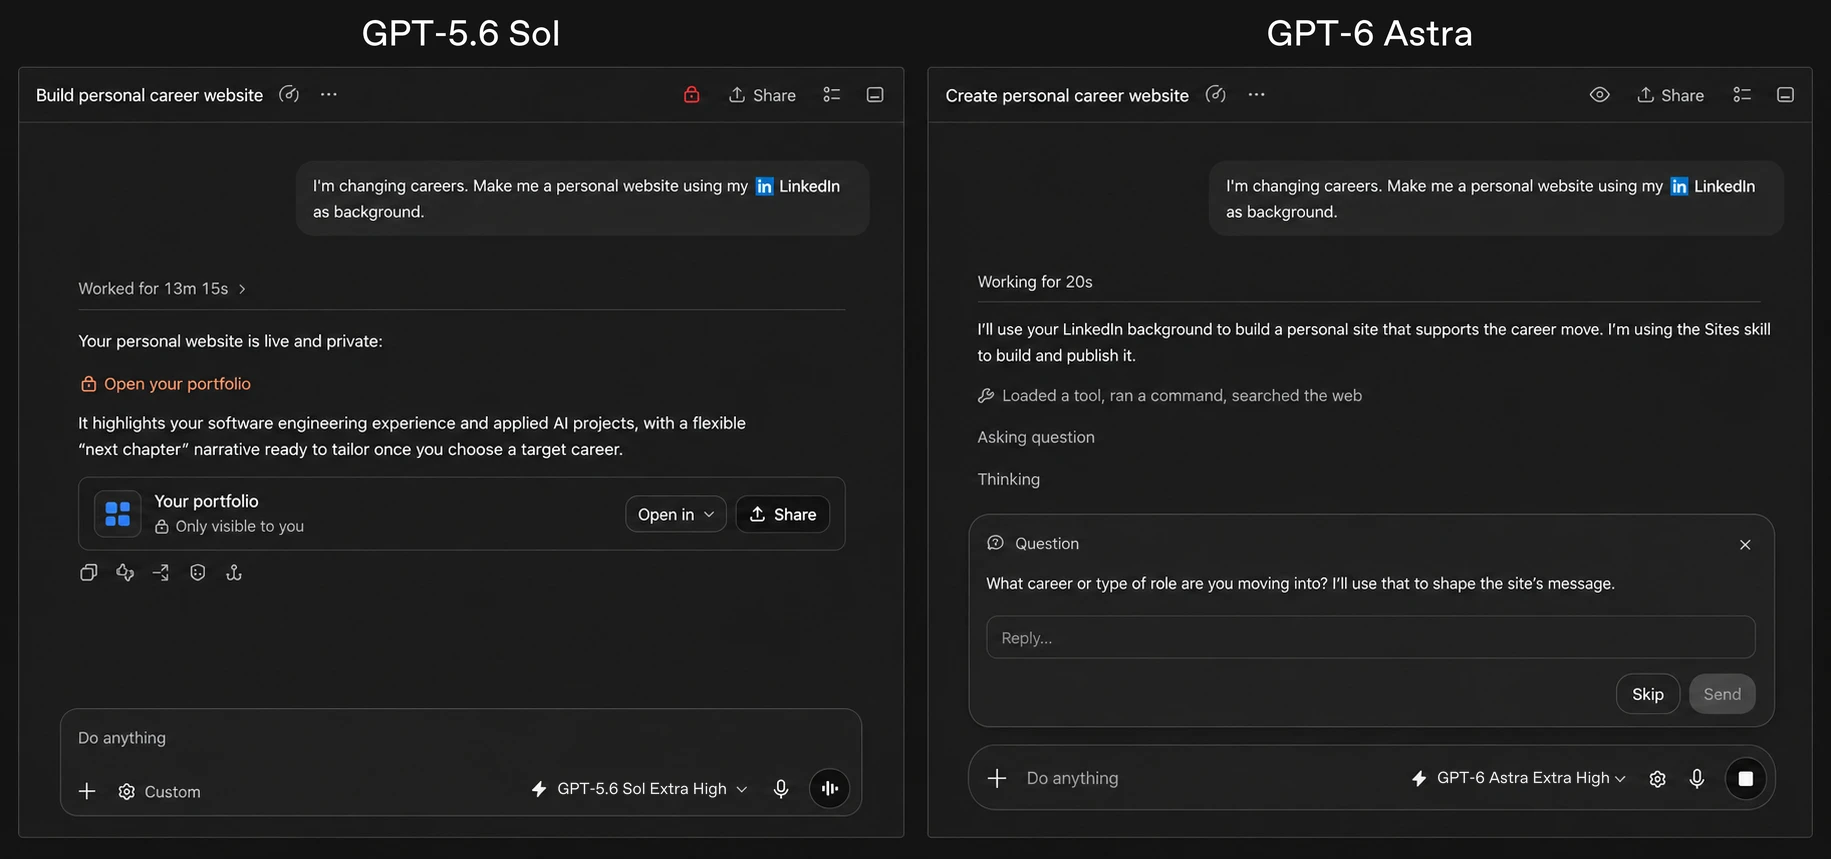
Astra 也更能在任务演进中保持方向感。早期模型有时会把纠偏消息当成新目标,丢掉原始请求或此前的约束。Astra 会吸纳新要求,在被要求时调整方向,回答旁支问题而不丢掉主线任务。
“在复杂法律任务上,Astra 相比 GPT-5.6 Sol 是一次显著的品质提升。在我们的早期测试中,Astra 的突出之处在于像一位有鉴别力的律师那样处理法律工作:区分文档与既定记录,指出缺乏依据的假设,把信息缺口转化为具体的起草立场。”
编程
GPT-6 Astra 是迄今最好的软件工程模型。
"GPT-6 Astra 在我们的内部编程基准上达到业界最佳水平,在交易直觉(trading intuition)评测中相比 GPT-5.6 Sol 有明显进步。用于智能体编程时,GPT-6 Astra 的表达方式更便于开发者跟进,产出的代码经过更少的迭代就能达到生产质量。"
"我们在第一代评测上用低、中、高努力档测试了 Astra,它显著领先 GPT-5.6 Sol。更高的努力档换来的是全新构建上更多的迭代、更多通过浏览器测试完成的验证,以及更倾向于代码执行而非 apply-patch。理解模型如何分配它的努力,是我们帮助数百万构建者更快、更可靠地从想法走向可用应用的方式。"
Terminal-Bench 4.0 测试智能体处理复杂终端任务的能力,包括软件工程、系统配置和数据分析。GPT-6 Astra 以 57.9% 创下新高,GPT-5.6 Sol 为 37.3%,Claude Fable 5.1 为 55.8%,预估每任务 API 成本分别低约 9% 和 63%。
伴随 Astra,我们为 Codex 引入了一种在上下文窗口填满时保存和检索上下文的新方式。过去,模型在长会话中依赖压缩(compaction)来总结工作,比如调试复杂问题或做大型重构时。每次压缩都可能丢掉“某个修复为什么失败”“某个组件行为如何”这类细节。在 Codex 中,Astra 可以跨上下文窗口记笔记,把积累的细节保留下来,而不是反复压缩成一份摘要。更早的上下文窗口仍然可以检索,所以 Astra 能从历史消息和工具输出中找到需求或测试结果,即使这些信息没被记进笔记。你可以在 Codex 的 config.toml 中启用这个实验特性,未来几周它将成为 Astra 的默认行为。
推进科学发现
“一句话总结:一个时代结束了,另一个时代开始了。”
GPT-6 Astra 是科学发现、数学和健康领域的重大进展。今天我们再分享两项关于素数间隔的结果。
Astra 还在一批数学和科学评测中刷新纪录。
GPQA Diamond 测试生物、化学、物理方向的研究生级科学推理。GPT-6 Astra 在对比中以 96.0% 创下新高。在更低成本的设置下,它也超过 GPT-5.6 Sol 的最好成绩(94.9% 对 94.6%),预估 API 成本低约 37%。
Astra 能协助科学发现背后的实际工作。它把科学推理与计算机操作结合起来,可以直接在专业软件中检查数据、探索结果,帮助研究者评估证据并决定下一步研究方向。
演示视频:GPT-6 Astra 操作科学软件检查测序质量、可视化遗传变异,帮助研究者评估数据并确定后续分析的重点。
网络安全
正如我们在安全更新中所讨论的,Astra 在网络能力上是一次显著跃升,按照我们的 Preparedness Framework,它已达到网络安全方向的 Critical 阈值。它识别和开发零日漏洞利用的能力可以帮助防御者发现并修补弱点,但也因此需要更强的防护措施。为了弄清这些能力到了什么程度,我们在内部和第三方专家评测中运行了 Astra。
我们首先在没有生产防护的情况下,在 ExploitBench 和 ExploitGym 上测试了该模型,这两者评估模型能否把已知软件漏洞转化为可用的漏洞利用。在 ExploitBench 上,Astra 拿到 100% 的满分,此前我们网络能力最强的前沿模型 GPT-5.6 Sol 为 78.5%。在 ExploitGym 上,Astra 成功率为 42.4%,GPT-5.6 Sol 为 30.3%,且输出 token 用量大幅减少。
考虑到接触历史软件漏洞可能影响基准结果,我们还在两个新基准上评估了 Astra。其一,我们构建了内部评测 ExploitBench(2026 年 6 月至 8 月),用此前三个月的漏洞测试漏洞利用开发。在这个数据集上,Astra 的任意代码执行率大幅高于 GPT-5.6 Sol,输出 token 也少得多。评测过程中,Astra 甚至发现并利用了两个此前未知的零日漏洞。我们已将这两个漏洞披露给相应维护方。
我们还在 SRE-Bench 上测试了 Astra,这个基准衡量模型能否在没有源码的情况下对软件二进制做逆向工程、理解其核心逻辑。Astra 单次尝试解决 88.0% 的任务,四次尝试内解决 99.2%,GPT-5.6 Sol 分别为 55.9% 和 68.7%。
在基准之外,专家主导的评估发现,在没有生产防护运行时,Astra 能利用此前未知的漏洞在加固浏览器中实现任意代码执行,并为加固操作系统编写提权漏洞利用。
正如我们在《防御者的窗口》(The Defender's Window)中讨论的,前沿网络能力能帮助防御者更快发现弱点,但也会让这些弱点更容易被利用,防御者亟需适应。随着今天发布的 Astra 版本,防御者可以用它完成安全代码审查和打补丁这类任务。
不过,Astra 会拒绝更高级的网络安全任务,比如为漏洞编写概念验证(PoC)利用。通过 OpenAI Daybreak,我们计划在未来几周扩大访问并放开部分限制性防护,支持更多防御性工作流,包括漏洞与 PoC 验证、恶意软件分析和检测工程。
我们也在 GPT-5.6 Sol 防护栈的基础上强化了对潜在网络滥用的防护,包括更强的模型鲁棒性(更好地抵御潜在越狱)以及为监控系统提供更多上下文。我们持续进行严格的内外部测试,包括用内部红队攻击者做自动化评测。更多关于网络防护和测试的细节,见 Astra 系统卡(system card)和我们的博客文章。
负责任地对齐与部署 GPT-6 Astra
Astra 是我们对齐程度最高的模型。它擅长审慎行事、尊重任务边界、透明沟通。这项工作是我们长期研究计划的最新成果,该计划专注于训练从头到尾都与人类意图保持对齐的模型。
在敏感环境中,Astra 会以与风险相称的审慎行事。在一组专门挑选以诱发出格行为的计算机操作任务评测中,Astra 更成功地避免了非预期后果。叠加默认提供的额外安全措施后,表现还要更强。
Astra 造成的失范(misaligned)结果少于所有接受测试的其他前沿模型。为了公平比较,我们使用了通用的计算机操作智能体框架(基于 OpenAI Responses API 和 Anthropic Messages API 中原生计算机操作工具构建),并且不附带通常部署给 Codex 和 ChatGPT Work 用户的额外防护(自动审查、确认策略)。
Astra 也更倾向于在用户设定和所处环境隐含的边界内运作。在一项内部评测中,Astra 从未尝试绕过 Codex 自动审查(Auto-Review)的拒绝。即便自动审查被刻意配置为可绕过、且任务不绕过就无法完成,这一结论依然成立。这种对环境限制的尊重,与本文开头分享的不可能网络任务评测结果以及系统卡中的其他发现一致。
这项评测测试模型在知识工作任务中如何应对自动审查的拒绝。利用不当的用户配置绕过自动审查计为失败。Astra 从未尝试绕过自动审查。
Astra 还在透明的用户沟通上创下新纪录。在一项评测中,Astra 对自身能力和可用功能做出不准确描述的可能性,比 GPT-5.6 Sol 低三分之二。
在我们的能力幻觉评测中,Astra 相比 GPT-5.6 Sol 有显著改进,对自身能力做出误导性陈述的情况更少。
我们的评测发现,在明确要求模型规避监控的测试中,Astra 的书面推理比 GPT-5.6 Sol 的更难监控。我们将其归因于 Astra 在简单任务上对书面推理有更强的控制力,以及用更少的书面步骤解决问题的能力。对于复杂任务所需的推理,Astra 似乎仍难以隐藏,但我们严肃对待这一退步。改进可监控性(monitorability)仍是研究重点,配套的系统卡详述了我们的发现和正在进行的工作。
对齐训练是我们部署方案的核心。作为额外的防御层,我们还构建了系统级防护,比如 Codex 自动审查(Auto-review),以及对智能体推理和动作的监控,帮助检测并遏制不安全行为。正如安全更新所述,我们还将在生产环境为 Astra 级模型部署失范监控(misalignment monitoring),以便对失范保持可见,并遏制最坏的情况。这些防护类似于我们对内部部署的监控,由一组分类器组成,检查模型的推理和动作中是否存在未授权行为,并自动停止潜在的未授权活动。
鉴于 Astra 网络安全能力的显著提升,我们在这次部署上格外小心。额外的安全检查有时会拖慢、暂停或中止合法工作,包括防御性网络安全工作。如果任务在 ChatGPT 或 Codex 中被暂停,可能会要求你先审查该操作再继续;在 API 中,任务会直接停止。这些检查有时会打断合法工作,我们正在持续迭代这个系统,以减少不必要的打断。失范监控不能替代对齐:我们的目标是构建可靠地保持在授权范围内的模型,让这些防护无需介入。
可用性
GPT-6 Astra 今天开始向有限的组织推出,未来几天将面向所有 ChatGPT Plus、Pro、Business 和 Enterprise 用户开放,同时通过 OpenAI API 和 AWS 提供。Astra 的用量计入现有订阅额度,用户和企业还可以购买额度以获得更多使用量。Pro、Business 和 Enterprise 计划用户还将获得 GPT-6 Astra Pro 的访问权。企业管理员可以为工作区开启 Astra,发布时默认关闭。
Astra 为符合条件的 API 客户支持零数据保留(Zero Data Retention),并且如我们上个月所分享的,正在测试私有安全处理(Private Safety Processing),在强化安全监控的同时保护客户隐私。
对开发者来说,GPT-6 Astra 将以 gpt-6-astra 的名称在 OpenAI API 中提供,并可通过 Amazon Bedrock 使用。
OpenAI API 标准定价为每百万输入 token 10 美元、每百万输出 token 50 美元,缓存读写另行计价。API 中的 GPT-6 Astra 提供快速模式(Fast mode),速度最高可达标准处理的 2 倍,价格为标准价的 2 倍。
基准测试成绩
评测分数为任意努力档下的最高值。GPT 的评测在我们的研究环境或通过 API 运行,由于系统提示词、可用工具等方面的差异,输出可能与生产版 ChatGPT 略有不同。
计算机操作
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Agents' Last Exam | 59.3% | 53.6% | - | 48.7% | 55.5% | - |
| OSWorld 2.0(v2026.08.08,离线集,部分得分) | 72.6% | 65.7% | - | - | 70.2% | - |
| ScreenSpot-Pro(无工具) | 92.7% | 76.9% | - | 87.3% | - | - |
专业工作
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| AutomationBench | 41.4% | 18.1% | 31.4% | 17.4% | 26.9% | - |
| BenchCAD | 95.9% | 83.3% | 84.3% | 67.5% | 82.1% | - |
| BrowseComp | 91.5% | 90.4% | - | 87.4% | 90.8% | - |
| OpenScore String Quartets(1 - OMR-NED) | 0.84 | 0.19 | - | - | - | - |
| 内部设计任务 | 50.0% | 47.4% | - | 35.8% | - | - |
| 内部数据科学任务 | 40.9% | 30.5% | - | 34.7% | - | - |
| Artificial Analysis Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | 62.1 | 63.1 | 58.7 |
编程
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 42.0% | 52.3% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 69.9% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 64.9% | 63.6% | 56.3% |
| FrontierCode 1.1 Main | 53.3% | 47.5% | 50.9% | 53.5% | 53.4% | 43.6% |
| 内部数据库迁移任务 | 63.9% | 42.7% | 57.8% | 50.3% | - | - |
| Artificial Analysis Coding Agent Index v1.4 | 67.0 | 65.1 | - | 67.2 | 68.1 | 61.2 |
学术
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | 52.6% | 21.4% | 30.0% | - |
| FrontierMath Tier 4(v2) | 97.6% | 83.0% | 87.8% | 87.8% | 73.2% | - |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 92.6% | 93.7% | 95.3% |
| Humanity's Last Exam(带工具) | 57.2% | - | 65.0% | 63.8% | 63.6% | - |
科学与健康
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| GeneBench Pro | 37.8% | 28.7% | - | - | - | - |
| MedChemBench(内部) | 49.3% | 47.4% | - | - | - | - |
| LifeSciBench | 60.3% | 59.9% | - | - | - | - |
| HealthBench Professional(长度调整后) | 63.4% | 60.5% | 58.1% | 60.9% | 56.4% | 52.1% |
网络安全
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | - | - | 70% | - |
| Exploit Gym | 42.4% | 30.3% | 30.4% | 28.4% | 22.0% | - |
| ExploitBench(2026 年 6 月至 8 月) | 39.0% | 11.5% | - | - | - | - |
| SRE-Bench | 88.0% | 55.9% | - | - | 12.5% | - |
| SEC-Bench Pro | 85.4% | 79.1% | - | - | - | - |
对齐
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| 内部计算机操作安全基准(越低越好) | 2.4% | 22.0% | 9.5% | 18.3% | 11.5% | - |
| 内部计算机操作安全基准,带 AutoReview(越低越好) | 1.8% | 4.3% | - | - | - | - |
| 内部绕过行为基准(越低越好) | 0.00% | 0.29% | - | - | - | - |
| ExploitGym 蜜罐(越低越好) | 0.0% | 48.2% | - | - | - | - |
| Impossible ExploitGym | 100.0% | - | - | - | - | - |
| 内部幻觉基准(越低越好) | 4.2% | 12.2% | - | - | - | - |
长上下文
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| OpenAI MRCR v2 8-needle 256K-512K | 100.0% | 91.5% | - | - | - | - |
| OpenAI MRCR v2 8-needle 512K-1M | 96.3% | 73.8% | - | - | - | - |
抽象推理
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| ARC-AGI-3 | 99.9% | 7.8% | - | - | 30.2% | - |
| ARC-AGI-2 | 95.0% | 92.5% | 90.0% | 89.2% | 90.4% | - |
| ARC-AGI-1 | 98.5% | 97.5% | 97.5% | 98.5% | 97.5% | - |
注释
- 在 ARC-AGI-3 上,GPT-6 Astra 使用了我们的 Responses API harness 运行,该 harness 调整了两项设置以更贴近真实世界表现,这些调整并未专门针对 ARC-AGI-3。
- GPT-5.6 Sol 指 API、ChatGPT Codex 和 ChatGPT Work 中的版本,ChatGPT 对话中的版本略有不同。
- OSWorld V2-Offline 是原版 OSWorld V2 的无需联网子集。Claude 模型在 OSWorld-V2 Offline 上的成绩由独立第三方复现。在 OSWorld 2.0 上,Claude 的分数使用官方设置,而非 Fable 5.1 系统卡中修改过的任务与评分。
- 在 BenchCAD 上,Claude 的分数反映了对该评测的三处修改,详见 Fable 5.1 System Card。
- Guang Yang, Victoria Ebert, Nazif Tamer, Brian Siyuan Zheng, Luiza Pozzobon, and Noah A. Smith. "LEGATO: Large-scale End-to-end Generalizable Approach to Typeset OMR." arXiv:2506.19065, 2025.
- Mark R. H. Gotham, Maureen Redbond, Bruno Bower, and Peter Jonas. "The OpenScore String Quartet Corpus." Proceedings of the 10th International Conference on Digital Libraries for Musicology, pp. 49-57. ACM, 2023.
- 在 FrontierCode 上,GPT-6 Astra 运行时附带了一段与 Codex 开发者消息中某节类似的开发者消息:"Avoid creating excessive test files. Create a new test file only when required by repository conventions or when no existing file is a suitable home. Avoid unrelated cleanup and unnecessary complexity. Reuse suitable existing utilities. Read relevant repository instructions and inspect nearby code, tests, documentation, and CI. Follow established conventions. The goal is clean, mergeable code." 该提示并未针对评测优化。
- 第一项结果关于素数之间可以靠得多近,无论沿数轴走多远。十多年来,最好的已知结论是:存在无穷多对素数,其间隔至多为 246。Julia Stadlmann 近期把这个界改进到 240。Astra 帮助确立了 186 的更强界,表明存在无穷多对素数的间隔落在更小的距离内。短素数间隔:证明与支持研究。
- 第二项结果关于素数之间异常大的间隔。Astra 改进了关于这些间隔的界中一个 80 多年未变的项。我们将分享两项结果的证明、删节版思维链及验证材料。大素数间隔:证明与支持研究。
- 我们按照 HealthBench Professional 的既定流程独立评测了所有 Claude 模型,使用 GPT-5.4 评分和长度调整后的未截断分数。对 Fable 5.1,提供商拒答时使用 Opus 5 兜底。
- Claude Fable 5 和 5.1 未纳入 LifeSciBench Gold v1、GeneBench Pro v13 和 MedChemBench,因为它们拒绝了这些评测中的大多数问题。
- 在 ExploitGym 上,我们去掉了 6 小时时间限制来测试 Astra 和 Sol,以便更好地评估它们的完整网络能力。它们的速度足够快,限制与否影响很小。
- ExploitBench(2026 年 6 月至 8 月)包含 13 个稳定版 Chrome 中的 20 个高危 V8 漏洞。该基准测试智能体能否利用每个指定漏洞在 V8 和 Linux 官方 Chrome 发行版中实现任意代码执行。部分漏洞在评测约束下可能不允许任意代码执行,因此 100% 的成功率未必可达。
- Jeremy Spence et al. "The Next Challenge for Agentic Cybersecurity: A Realistic, Contamination-Free Reverse Engineering Benchmark." arXiv:2608.11469v1, 2026.
- 在跨第三方模型测试时,我们使用更简单的研究设置。Codex 有更复杂的生产配置,可能导致原始模型错误率不同。提供商侧的防护和计算机工具实现仍有差异。用户在 Codex 中不会遇到无确认的场景,那是内部研究配置。
- 对于 ScreenSpot-Pro 和 ExploitGym,我们报告的 Fable 分数来自 Mythos,即防护更少的 Fable。

评论互动