GLM-5.3 发布:后训练规模化带来的前沿编码与涌现安全能力
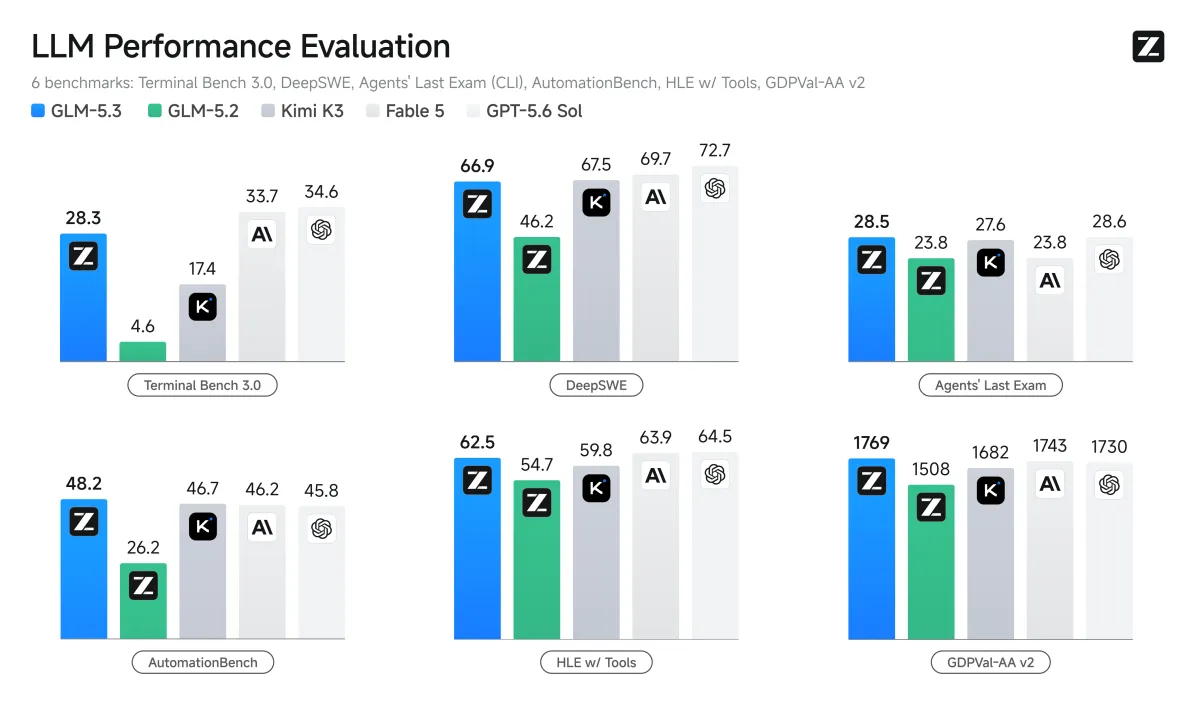
- 规模化后训练使 GLM-5.3 编码能力比 GLM-5.2 提升 50%,在多个基准上取得开源 SOTA
- 安全能力涌现,漏洞挖掘 CyberGym 达 SOTA,漏洞利用成绩超 GLM-5.2 两倍
- 基于 slime 框架实现高效长程 RL 训练,端到端吞吐提升 2.3 倍
- 权重将在发布两周后开源,支持 API 和本地部署,并提供新版 Coding Plan
对 GLM-5.3,我们做的事情只有一件:规模化后训练。 在 GLM-5.2 中我们搭好了技术栈:用于高效长上下文处理的 IndexShare、面向长程任务 RL 的 SAO,以及用于大规模异步训练的 slime,它们都运行在我们持续积累的长程任务环境上。过去一个月,我们在这个栈上继续扩规模:更多环境、更多样的任务,以及投在它们上面的更多算力。
今天我们发布 GLM-5.3。它与 GLM-5.2 使用同一个基座模型,所有提升都来自后训练。与 GLM-5.2 相比,它在复杂编码和长程任务上的表现显著更强:
- 更强的编码能力:GLM-5.3 是目前编码能力最强的开放权重模型,在我们内部的 Z.ai Code Bench 上较 GLM-5.2 提升 50%,并在 Terminal Bench 3.0、Agents' Last Exam 等公开基准上取得开源 SOTA。
- 涌现的网络安全能力:随着后训练规模扩大,安全能力的发展超出了我们的预期。GLM-5.3 在漏洞挖掘基准 CyberGym 上达到 SOTA,且越靠近利用链(exploitation chain)后段提升越大,在漏洞利用类基准上成绩超过 GLM-5.2 的两倍。
- 开源:安全评估与加固完成后,我们将在发布两周后开放权重。
| 基准 | GLM-5.3 | GLM-5.2 | Kimi K3 | DeepSeek-V4 Pro-0813 | Qwen3.8-Max | Opus 4.8 | Fable 5 (w/ fallback) | GPT-5.6 Sol |
|---|---|---|---|---|---|---|---|---|
| 编码 | ||||||||
| Terminal Bench 2.1 | 88.2 | 81.0 | 88.3 | 87.9 | 86.6 | 85.0 | 88.0 | 88.8 |
| Terminal Bench 3.0 | 28.3 | 4.6 | 17.4 | - | - | 21.1 | 33.7 | 34.6 |
| DeepSWE v1.1 | 66.9 | 46.2 | 67.5 | 62.7 | 56.6 | 58.0 | 69.7 | 72.7 |
| NL2Repo | 58.0 | 48.9 | 58.0 | 61.1 | 55.9 | 69.7 | - | - |
| ProgramBench Almost Solved | 19.0 | 9.5 | 17.5 | - | 10.5 | 15.5 | 33.0 | 23.0 |
| FrontierSWE | 78.1 | 67.5 | - | - | - | 66.5 | 88.2 | - |
| SWE-Marathon v1.1 | 42.5 | 19.4 | 48.1 | - | - | 48.8 | 33.1 | 42.5 |
| PostTrainBench | 39.8 | 31.7 | 32.0 | - | - | 32.9 | 41.8 | 36.2 |
| 安全 | ||||||||
| CyberGym | 84.5 | 77.2 | 80.0 | 83.3 | 78.5 | 78.1 | 83.8 | 83.6 |
| ExploitGym 2h / 6h | 105 / 130 | 29 / 39 | 36 / 70 | - | 14 / 26 | 80 / 120 | 181 / 247 | 216 / 293 |
| ExploitBench | 54.4 | 24.4 | 32.2 | - | 28.8 | 40.0 | 78.0 | 76.5 |
| 智能体 | ||||||||
| Toolathlon Verified | 73.0 | 59.9 | 76.5 | 74.1 | 72.5 | 76.2 | 74.7 | 74.9 |
| AutomationBench v1.0.6 | 48.2 | 26.2 | 46.7 | 43.2 | 39.8 | 41.0 | 46.2 | 45.8 |
| Agents' Last Exam ALE-CLI | 28.5 | 23.8 | 27.6 | 25.7 | 27.0 | 25.7 | 23.8 | 28.6 |
| HLE w/ Tools | 62.5 | 54.7 | 59.8 | 60.0 | 56.2 | 57.9 | 63.9 | 64.5 |
| GDPval-AA v2 | 1769 | 1508 | 1682 | 1590 | 1739 | 1588 | 1743 | 1730 |
更强的编码能力
在 GLM-5.3 上,我们把环境规模化的方向推向了那些不太像编程练习、而更像真实专家工作单元的任务。现在的环境覆盖了更广的生产工作流,任务按照工程和研究工作的实际开展方式设计,其中一些相当于有经验工程师数天的工作量。以一个机器学习基础设施任务为例,模型会拿到与工程师相同的工作环境,可以访问计算集群、存储系统、内部文档、代码库和实验结果,需要诊断训练栈各环节的瓶颈、实施优化、跑实验,并在保证正确性的前提下交付可度量的端到端加速。在这种水平的环境上训练,推动模型学会端到端地承担完整的大型工作,而不是依赖用户拆解问题并逐步监督。
随着智能体能力提升,后训练规模化的难点很大程度上从模型转移到了环境。一个有用的任务环境必须可执行、可验证,并贴近真实的专业工作,而且我们需要大量这样的环境,而不是少数手工搭建的。为了规模化这一过程,我们构建了端到端合成环境的流水线,对其中一部分任务还合成了 RL 奖励信号。研究智能体从真实工作中收集任务模式,将其转化为带有多步依赖和隐藏状态的可运行长程环境;随后一个裁判智能体会亲自尝试每个任务,验证它确实可解。验证器在合成时不接触参考解,而求解轨迹则用来发现并封堵奖励捷径。通过 oracle、no-op 和未解状态检查的验证器,能产出足够可靠、可直接用于训练的二值奖励。
GLM-5.3 沿用了 GLM-5.2 引入的 RL 策略,包括带压缩的 SAO,这有助于让这些提升在长程任务上保持,而不只体现在短任务上。这一效果在编码和通用智能体任务上都有体现:Terminal-Bench 3.0 从 4.6 提升到 28.3,DeepSWE v1.1 从 46.2 提升到 66.9,Agents' Last Exam 从 23.8 提升到 28.5。这些流水线目前仍需要相当数量的人工参与,让环境生成与验证更加自主是接下来的方向之一。
在公开基准之外,我们还推出了 Z.ai Code Bench,一个内部基准,用于在真实用户场景下评估编码智能体。它覆盖多样的任务类别,并将智能体置于复杂的本地开发环境中。在不同努力等级下,我们从两个维度评估智能体:端到端任务完成率和细粒度检查清单准确率。作为非公开基准,Z.ai Code Bench 也降低了公开测试集污染的风险,能更真实地衡量真实用户体验。
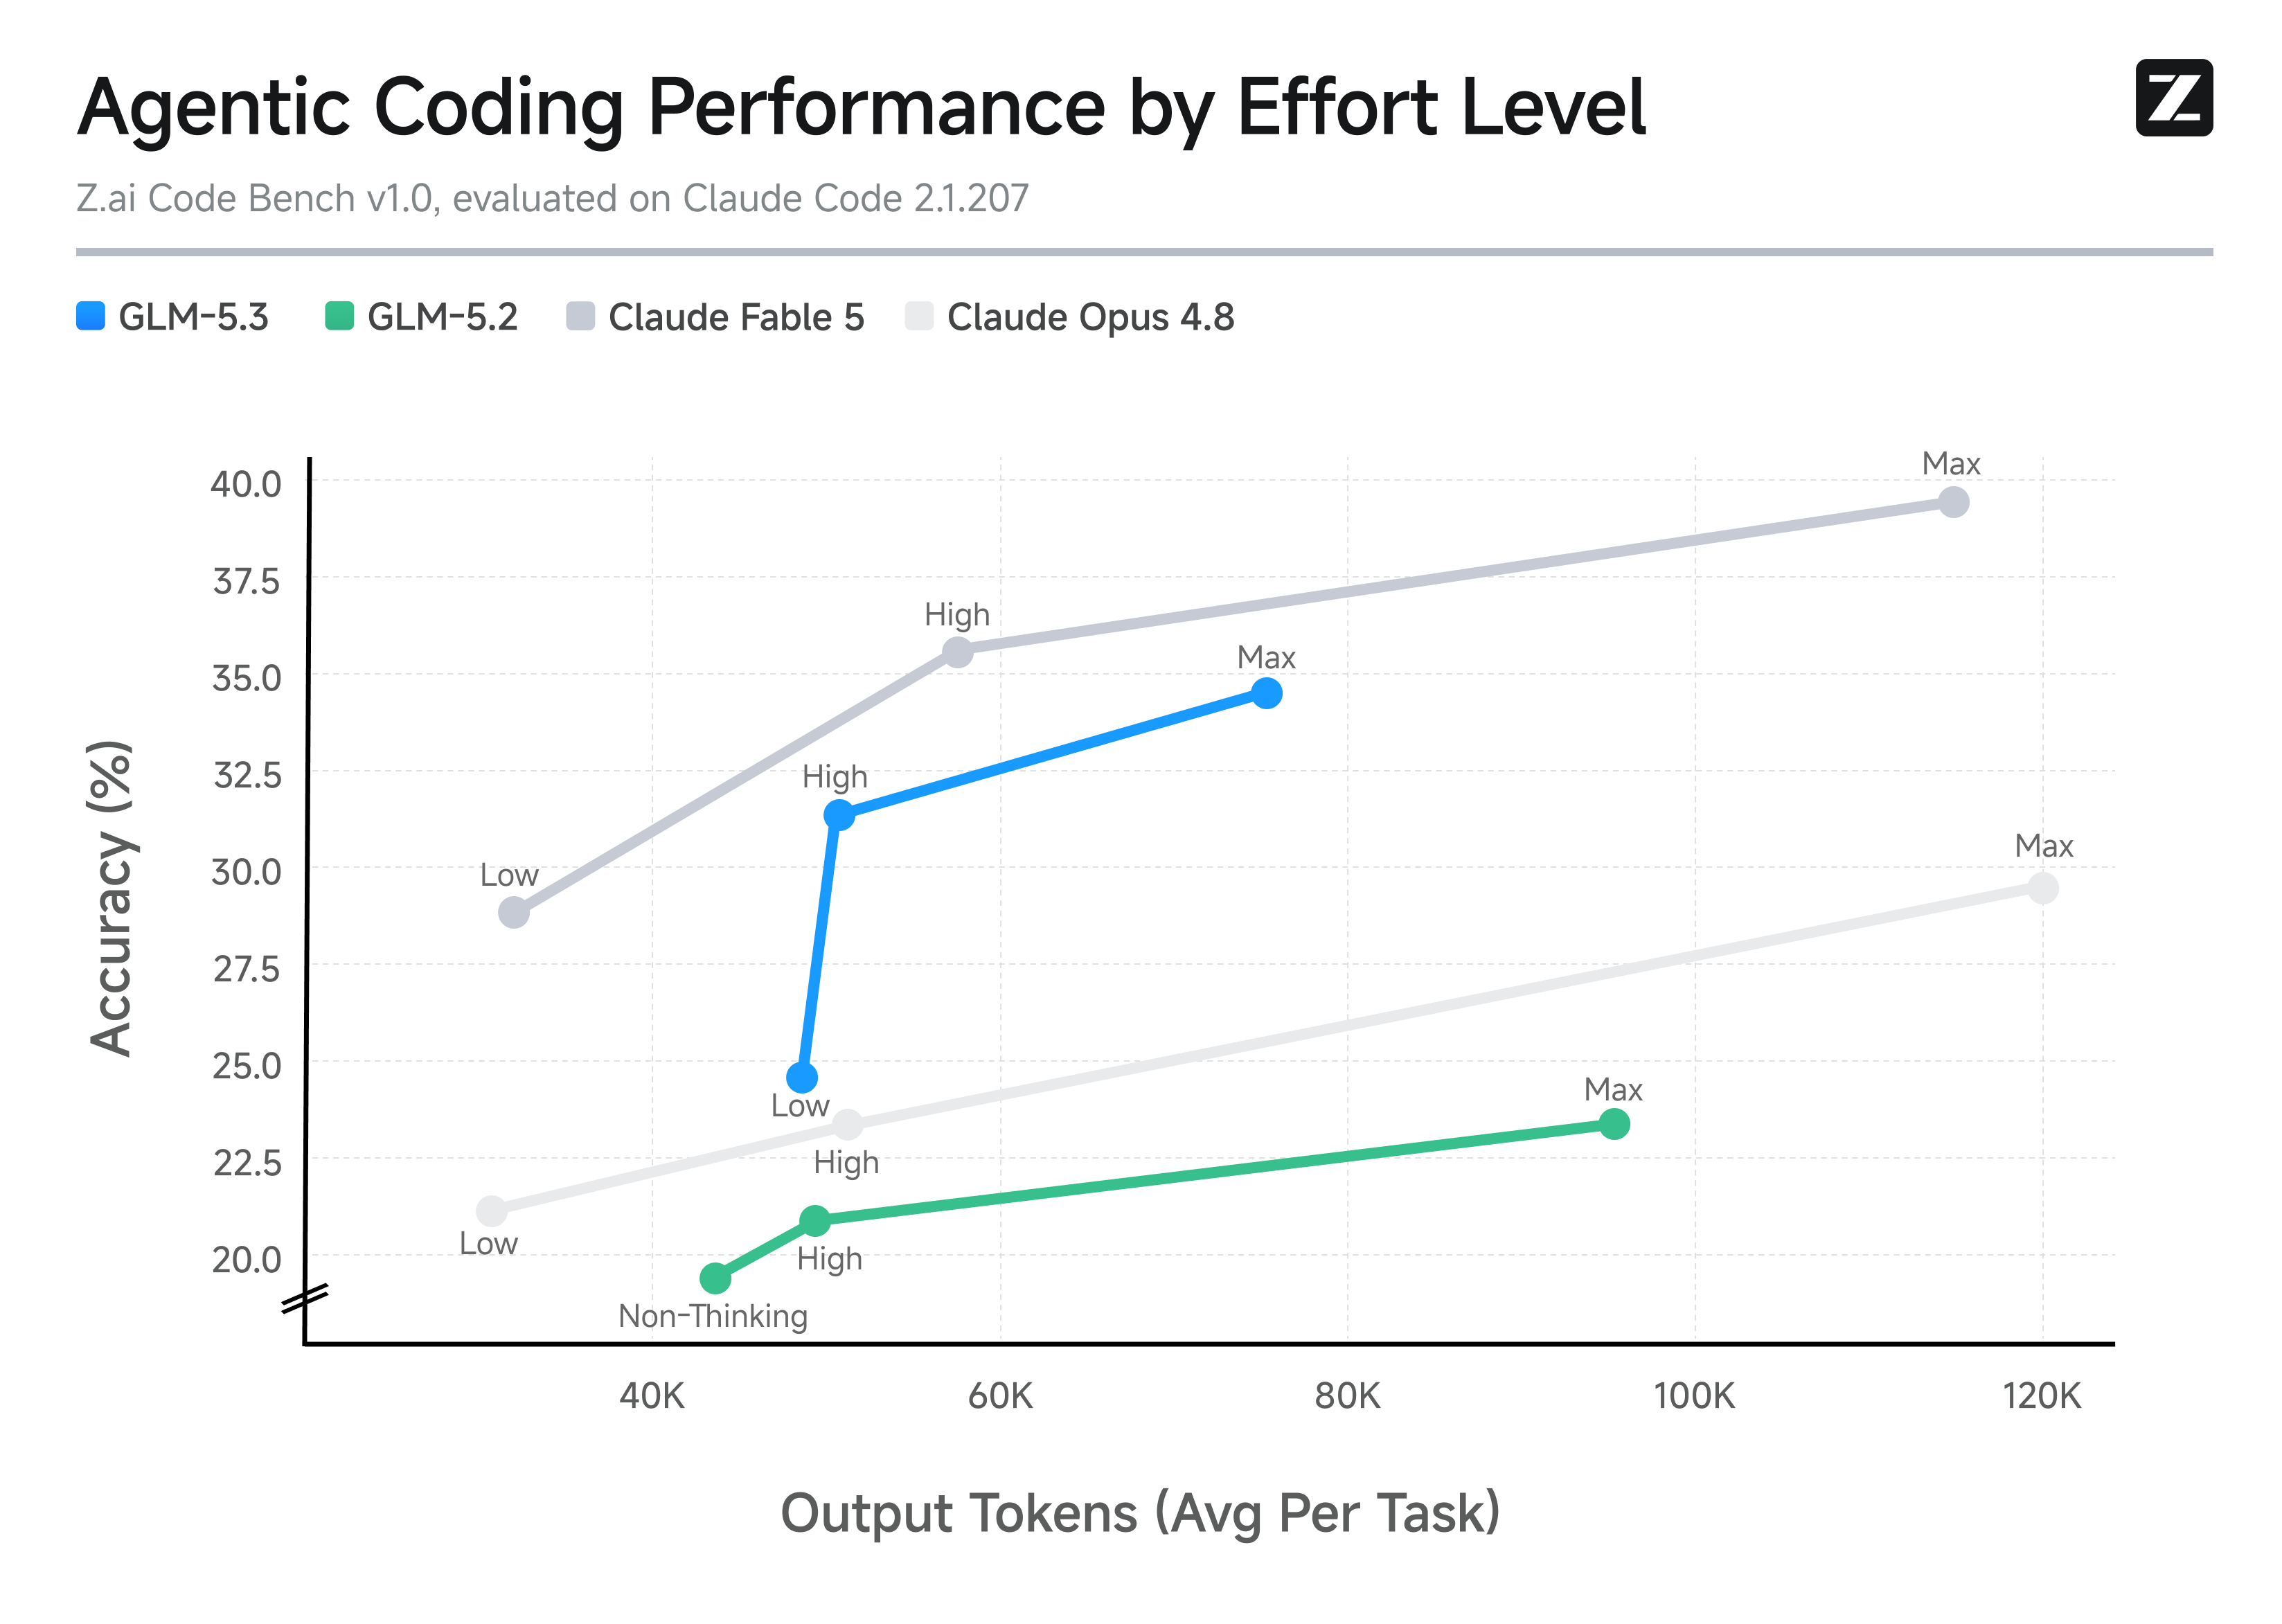
如图所示,GLM-5.3 在性能和 token 效率上都有提升。在每个努力等级上,它都以更少的输出 token 取得了明显强于 GLM-5.2 的智能体编码成绩。在 Max 努力等级下,GLM-5.3 每任务消耗约 75K 输出 token 达到 34.5%,而 GLM-5.2 需 96K token 达到 23.4%。面对闭源模型同样如此:在 High 努力等级下,GLM-5.3 以约 50K 输出 token 达到 31.4%,超过需要 120K token 达到 29.5% 的 Claude Opus 4.8。GLM-5.3 仍落后于在 Max 努力等级下达到 39.5% 的 Claude Fable 5。
涌现的网络安全能力
作为后训练的一部分,我们在训练混合数据中加入了漏洞挖掘数据和环境。我们预期这会让模型更擅长发现漏洞和推理漏洞,但出乎意料的是,随着训练规模扩大,这项能力持续发展的速度。GLM-5.3 不只是更擅长识别孤立的缺陷:它开始跨利用的多个阶段进行推理,为完整的利用链形成连贯的计划。
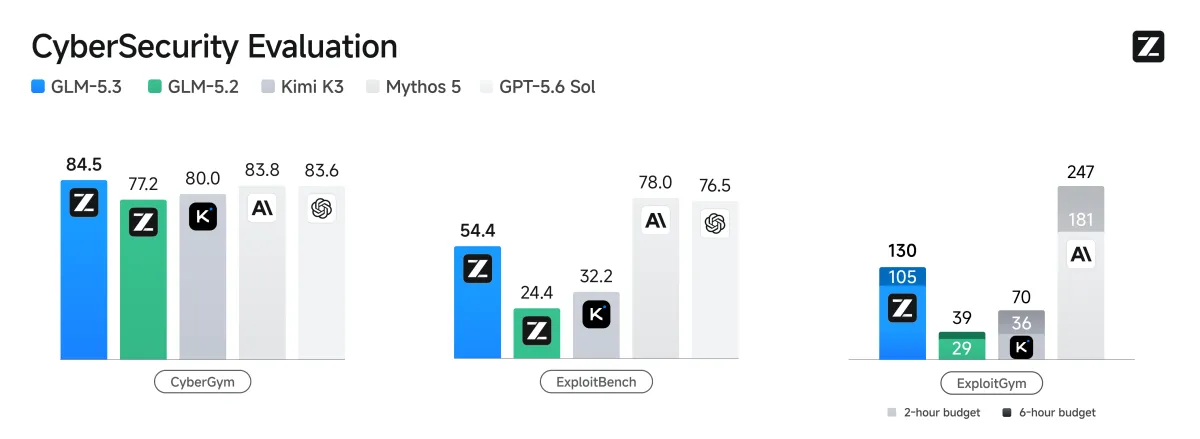
我们在覆盖漏洞分析与利用不同阶段的三个基准上评估 GLM-5.3。CyberGym 从白盒源代码出发,测试模型能否通过触发故障来识别并验证漏洞,GLM-5.3 得分 84.5%,高于 GLM-5.2 的 77.2%,是该基准上的最好成绩,领先于 Mythos 5(83.8%)和 GPT-5.6 Sol(83.6%)。ExploitBench 要求对真实漏洞及其利用进行更深入的推理,GLM-5.3 达到 54.4%,是 GLM-5.2(24.4%)的两倍多,而 Mythos 5 和 GPT-5.6 Sol 分别为 78.0% 和 76.5%。ExploitGym 度量模型在时间归一化预算下能完成多少利用任务,GLM-5.3 在两小时内完成 105 个任务、六小时内完成 130 个,GLM-5.2 则分别是 29 和 39;预算使用各模型吞吐数据做了归一化,细节见脚注。Mythos 5 仍以 181 和 247 个任务明显领先。三个基准的模式一致:基准越靠近利用链后段,相对 GLM-5.2 的提升越大,与闭源前沿的差距也越大。能力增长最快的,恰恰是我们落后最远的地方。
随后我们测试了这些能力能否迁移到受控基准之外。自 GLM-5.2 起,我们与国内多个安全团队合作,用真实代码库检验我们的模型。经过专家评审、筛查和去重后,模型在 269 个项目中识别出 2436 个漏洞,其中包括 1097 个中高危问题。这些发现涵盖系统内核、操作系统、浏览器引擎、开源基础设施、Web 应用和网络协议,其中很多已多年甚至数十年无人察觉,最古老的可以追溯到约 40 年前。
这项工作后来发展成一项持续的漏洞披露行动。我们建立了 Z.ai Security Disclosure Ledger,在发现走披露流程的同时维护公开记录。账本随着新漏洞的评审和披露持续更新,区分已公开和仍在披露中的问题。对已披露的问题,它记录的信息包括受影响项目、严重程度、CVE 编号(如有),以及该漏洞在代码库中存在了多久。
- 追踪的发现总数:2436
- 已公开披露:53
- 披露 embargo 中:2383
- 严重及高危:1097
- 涉及开源项目:269
这些发现的时间跨度达 45 年:最古老的缺陷引入于 1981 年,平均而言一个漏洞在被发现前已存在 26.6 年。
严重程度分布:Critical 107 / High 990 / Medium 1286 / Low 53
查看 Z.ai Security Disclosure Ledger
slime:为长程 RL 扩缩而建
这一切都运行在 slime 上,它是我们开源的 RL 扩缩后训练框架,训练侧基于 Megatron,rollout 侧基于 SGLang。其设计将训练、rollout 和数据缓冲保持在单一数据流上,数学、代码、沙箱、验证器和长程智能体环境都以数据生成的形式接入,而无需改动训练循环。正是这一点让我们在 GLM-5.2 和 GLM-5.3 期间持续增加环境,而不用每次重建训练栈。
在 GLM-5.3 周期中,我们沿两条线继续建设。算法侧新增了面向 RL 研究的能力:top-p mask、top-k 和全词表 OPD,以及提升训练与 rollout 一致性的配置,包括 R3 式设置和训练、rollout 两条路径间的完整数值对齐。这让我们能更精细地控制采样、训练和教师信号,也能快速开展对照实验。在我们的训练- rollout 一致性评估中,log 概率(logprob)的平均差异被控制在 1e-7 量级,相比此前的设置降低了超过 99.99%。
我们还针对大规模 RL 的资源效率和系统吞吐做了工作。本地存储现在作为额外的缓存层,分层保存原本会驻留在主机内存中的模型状态和数据。这对多教师 OPD 尤为重要:配合训练侧的动态教师切换和预取,可以同时使用多个教师,而无需为每个教师单独搭建常驻推理服务,附加开销有限,资源消耗大幅降低。针对智能体和异步负载,我们改进了路由器与 slime 之间的联合调度和负载均衡,让长度和完成时间差异巨大的 rollout 请求更好地利用推理资源。我们加入了负载感知的启发式策略,根据每个 rollout 环境的特征推导面向吞吐的配置,包括 prefill/decode 资源比例、并发设置等吞吐关键参数。结果是,在长程编码 RL 任务上,这些系统级优化将端到端 RL 训练吞吐提升了 2.3 倍以上,让我们能以更高的效率在更长的轨迹和更复杂的环境上扩缩训练。
综合起来,这些改进带来了更多实验灵活性、更低的资源成本和更高的吞吐,这正是让持续扩缩 RL 变得可行的原因。
上手 GLM-5.3
GLM-5.3 的 API 变化
GLM-5.3 支持三档思考努力等级:low、high 和 max。GLM-5.3 不再支持关闭思考。
思考参数
| 参数 | 取值 | 默认值 | 说明 |
|---|---|---|---|
thinking.type | enabled | enabled | 启用思考。disabled 不再支持。 |
reasoning_effort | low, high, max | max | low:轻量;high:增强;max:深度。 |
编码任务推荐使用 max。
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}需要迁移:如果你的应用目前使用 thinking.type: "disabled",请先改为 enabled 并将 reasoning_effort 设为 low,再更新模型 ID 为 glm-5.3。否则请求会失败。
在 GLM Coding Plan 和 ZCode 中使用 GLM-5.3
在你常用的编码智能体中试用 GLM-5.3,包括 ZCode、Claude Code、OpenCode 等。参见 https://docs.z.ai/devpack/overview。
面向 GLM Coding Plan 订阅用户:GLM-5.3 已推送给所有 GLM Coding Plan 用户。新的 GLM Coding Plan 采用积分制配额,输入、缓存输入和输出 token 分别计费。非高峰时段的模型调用消耗标准积分的 50%。高峰时段为周一至周五 14:00–18:00(UTC+8),其余时段(含周末)享受非高峰 5 折费率。立即开始构建:https://z.ai/subscribe
用 ZCode 更好地发挥 GLM-5.3
- 98% 以上的缓存命中率,重复上下文按更低的缓存费率计费,相当于多出约 30% 的有效 token;
- 1.5 倍限时配额提升,与缓存节省叠加后,8 月 31 日前最高可达标准配额的 180%;
- 长程任务掌控力:Goal 模式会规划、编码、测试并验证,直到达成目标;
- Remote Control:通过微信或飞书在手机上监控和引导长时间运行的任务。
试用 ZCode:https://zcode.z.ai/
本地部署 GLM-5.3
GLM-5.3 的模型权重将在两周后公开发布。
脚注
- HLE w/ tools:评估使用
temperature=1.0、top_p=0.95的采样参数,最大生成长度163,840token。评估在最大上下文长度300,000token 下进行,并使用上下文管理策略。裁判模型为 GPT-5.6-luna (medium)。 - NL2Repo:我们在 1M 上下文下以 temperature=1.0、top_p=1.0、max_new_tokens=64k 评估 NL2Repo。为防止作弊,我们使用基于规则和基于 LLM 的双重判断来阻止恶意行为(如未授权的 pip 或 curl 操作)。
- DeepSWE:使用 mini-swe-agent harness 运行 DeepSWE,参数为
temperature=0.95、top_p=1.0、timeout=6h,上下文 400K。 - Terminal-Bench 2.1:在 Claude Code 2.1.207 中评估,temperature=1.0、top_p=1、max_new_tokens=65536,超时 6 小时。
- Terminal-Bench 3.0:使用 Claude Code 2.1.207 harness(reasoning effort=max、400K 上下文、128K 最大输出)评估 Terminal-Bench-3 任务,报告每任务三次 rollout 的 avg@3。每次 rollout 在由任务官方镜像构建的隔离容器中运行,上限 600 个智能体轮次和 10 小时超时。禁用 Tool Search,各智能体产出的工件由任务官方的独立验证器评分。
- Agent's Last Exam (CLI):使用官方评估协议和 Claude Code harness(reasoning effort=max、1M 上下文、64K 最大输出)评估 ALE。105 个任务各自在隔离 Docker 容器中运行,使用 Task Card 声明的资源。默认超时 4 小时,任务特定限制优先(最长 8 小时)。禁用 Tool Search,结果由官方 ALE 评估器评分。
- Toolathlon Verified:所有结果通过官方评估服务获取,报告 3 次独立运行的平均 pass@1。
- AutomationBench:在 AutomationBench v1.0.6 上评估,包含 PR #13 引入的
null类型处理问题修复。 - GDPval-AA v2:模型由 Artificial Analysis 评估。
- CyberGym:在 Claude Code 2.1.207 中评估 GLM-5.3(max reasoning effort、无网络工具,temperature=1.0、top_p=1.0、max_new_tokens=128000)。所有评估不限任务超时,结果为 1507 个任务上的单次运行 Pass@1。为模拟真实使用场景,我们将智能体置于任务容器内,移除所有 Git 相关信息,并应用域名白名单(仅允许 pypi.org、deb.debian.org 等基础工具安装所需的关键域名)以防作弊。
- ExploitGym:在 Claude Code 2.1.207 中评估 GLM-5.3、Kimi-K3 和 Qwen3.8 Max(max reasoning effort、无网络工具,temperature=1.0、top_p=1.0、max_new_tokens=128000)。报告的结果是 869 个任务在两种超时预算(2 小时和 6 小时)下的单次运行 Pass@1,计算方式为按各模型每秒 token 数(TPS 数据来自 Artificial Analysis)折算的 API 推理时间,再加上非 API 开销。也就是说,GLM-5.3 的结果按 115 TPS 折算,Kimi K3 按 40 TPS,Qwen3.8 Max 按 47 TPS。我们同样应用域名白名单以防作弊。
- ExploitBench:在 Claude Code 2.1.207 中评估 GLM-5.3(max reasoning effort、无网络工具,temperature=1.0、top_p=1.0、max_new_tokens=128000)。遵循官方评估设置,我们将智能体与环境的最大交互轮次限制为 300,并对 41 个任务在 3 次修订上取平均覆盖率得分。任务覆盖率由各修订达成能力的并集决定,平均分由各结果平均得出。我们同样应用域名白名单以防作弊。
- FrontierSWE:评估由 Proximal 进行,1M 上下文长度、max 努力等级、128K 最大输出 token。Dominance 得分截至 2026/08/14。
- PostTrainBench:使用 Claude Code 2.1.207 评估 GLM-5.3,max 努力等级、temperature=1.0、top_p=1.0、max_new_tokens=128000、1M token 上下文窗口。报告 3 次运行的加权平均。未能产出得分的运行回退到官方零样本基座模型基线得分。在防止使用第三方 API 的检查方面,我们移除了原先基于模式匹配的检查,因为它在本地 vLLM 端点通过 OpenAI SDK 访问时会产生误报,改为使用 LLM 智能体检查方案中是否使用了外部 API。
- SWE-Marathon:使用 Claude Code 2.1.207 评估 GLM-5.3,max 努力等级、temperature=1.0、top_p=0.95、max_new_tokens=128000、1M token 上下文窗口。对于
strip-clone,原始防作弊检查的 import 检测范围过宽,可能误拒正确实现,我们移除了相关检查并改用基于 LLM 的检查以避免误报。对于parameter-golf和trimul-cuda,NVIDIA wheel 的变更导致 Docker 镜像构建失败,因此我们添加了--extra-index-url https://pypi.org/simple以恢复构建。

评论互动